EVERWORLD / 产品与技术指南
EverWorld 愿景与技术架构
一个可以互动、可以编排,并与角色共同推动变化的世界。
EverWorld 面向互动直播、互动影游与沉浸式娱乐,以实时互动空间视频,让玩家通过探索、行动和交流改变接下来发生的事。
1.0 深化交互与连续生成,2.0 扩大空间规模与控制能力,3.0 实现自主智能体与实时多模态互动。
三个版本沿用同一技术底座。先了解每一版带来的体验,再看对应架构;持久记忆、时间无限流和其他核心机制,可在下方按主题展开。
1.0产品能力与技术架构
交互式场景生成
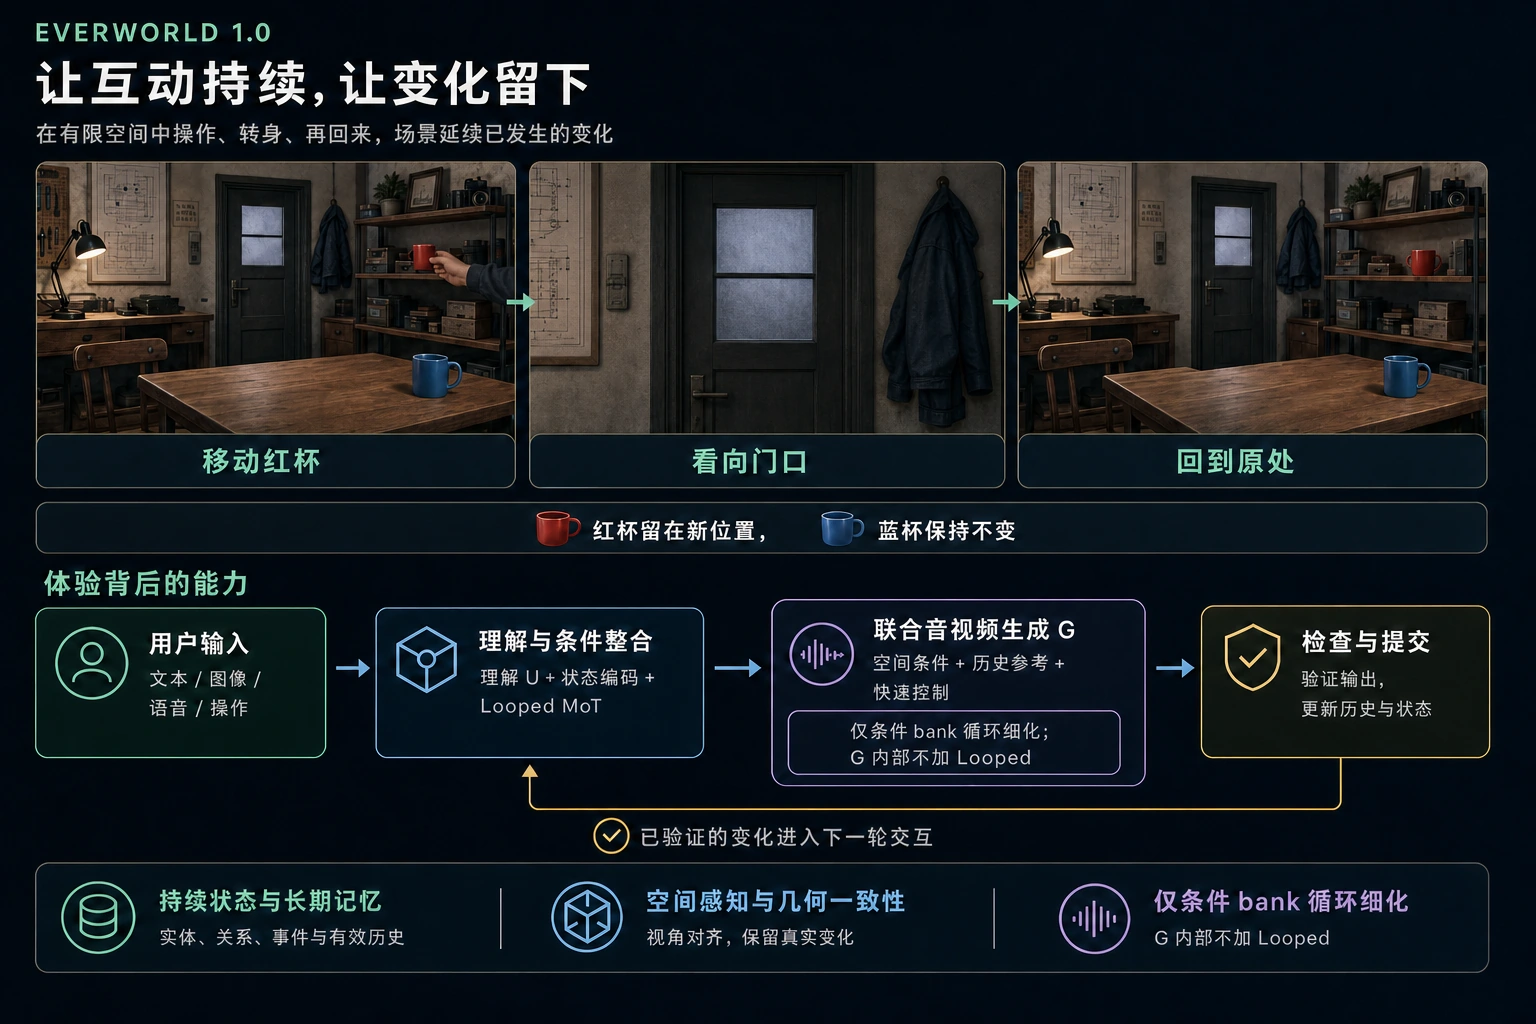
让房间或小型连通场景成为可持续游玩的体验:输入驱动连贯场景动态,音视频持续生成,身份与互动后果跨视角延续。
能力如何实现
- 01可游戏化的场景互动
- 将玩家输入绑定到主体、目标、动作阶段与事件;通过语义条件和快速控制,驱动连贯的场景动态与视听反馈。
- 02持续音视频生成/无限流
- 将固定片长生成扩展为块因果生成与自身历史续写,结合有界上下文、长期记忆检索和缓存管理;通过少步生成等优化降低交互延迟。
- 03跨视角的时空一致性
- 加入对象级 3D 感知、多视角一致化和目标视角重投影;分别处理静态空间与动态前景,以深度、掩码、轨迹和姿态约束生成。
- 04互动后果持续存在
- 以版本化状态和事件记忆保存变化,按当前状态读取有效历史;避免旧外观覆盖新状态,以及一次性声音重复播放。
模型重点
保留 H3 U—MoT—G 底座,强化状态、几何和历史条件。Looped 仅细化 MoT 条件 bank,G 内部不加循环。首阶段以房间或小型连通场景验收,时间无限流与空间规模分别验证。
2.0产品能力与技术架构
大规模空间编排
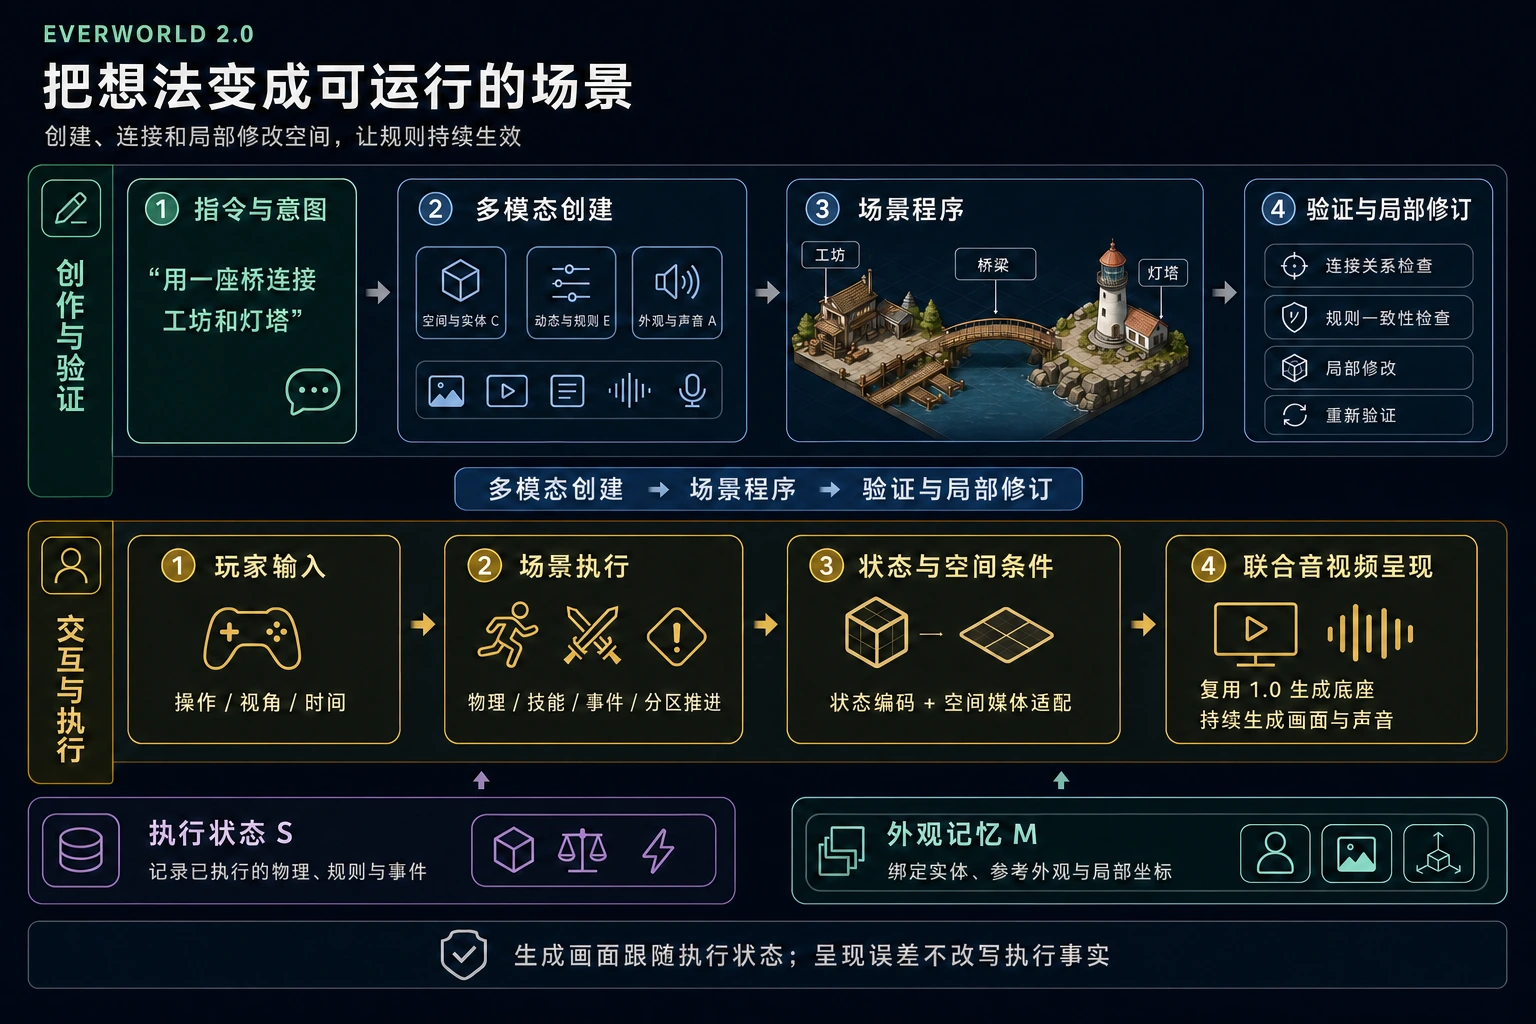
让连通空间与场景动态可规划、可执行、可控制。通过分层组织扩大空间规模,沿用共同的音视频生成底座。
能力如何实现
- 01更大规模的连通空间
- Coding MLLM 分层规划区域、建筑、房间与实体;通过全局拓扑、局部坐标、分区加载和事件驱动更新,实现跨区探索与状态延续。
- 02通过自然语言创建和编辑场景
- Coding Agent 生成 C/E/A 可执行表征:空间与物理组成 C、动态规则 E、外观与声音 A;通过执行预览、约束检查和局部修订提高可靠性。
- 03即时生成式对象与实体级控制
- 用粗几何、碰撞体、关节和功能区域承载执行,生成模型赋予丰富外观。功能属性落实为规则与状态变化,外观通过实体 ID 和局部坐标绑定。
- 04模拟结果稳定约束视听生成
- 增加两路条件:层级状态编码 → MoT,表达实体、关系与事件;几何/运动/外观条件 → G,约束位置、遮挡、运动和视觉身份。
模型重点
在 1.0 上增加外部 Coding Agent、可执行场景底座和执行条件编码。分别维护程序 p、执行状态 S、外观记忆 M;执行器推进已建模动态,生成器负责视听呈现。高质量画面仍依赖生成,主要研究难点是让它持续遵从执行结果。
INSTANT 3D OBJECT + SCENE SIMULATION
从粗模到可交互对象
Code 保存对象的生成与作用配方。物理代理持续存在,生成模型依据同一配方呈现丰富外观。
粗几何代理
长方体 · 局部坐标 · 握持区域
可执行属性
刚体 · 接触 · 热作用规则
生成条件
钢铁 · 符文 · 持久外观编码
运行状态
位姿 · 速度 · 温度
创建Coding Agent → C/E/A 程序 → 执行、验证与修订
运行输入 → 执行状态 S → 状态/空间编码 + 外观记忆 M → AV 生成
程序 p、执行状态 S、外观记忆 M 通过身份和坐标绑定。功能效果必须执行,画面偏差不能改写状态。
3.0产品能力与技术架构
智能体驱动的场景演化
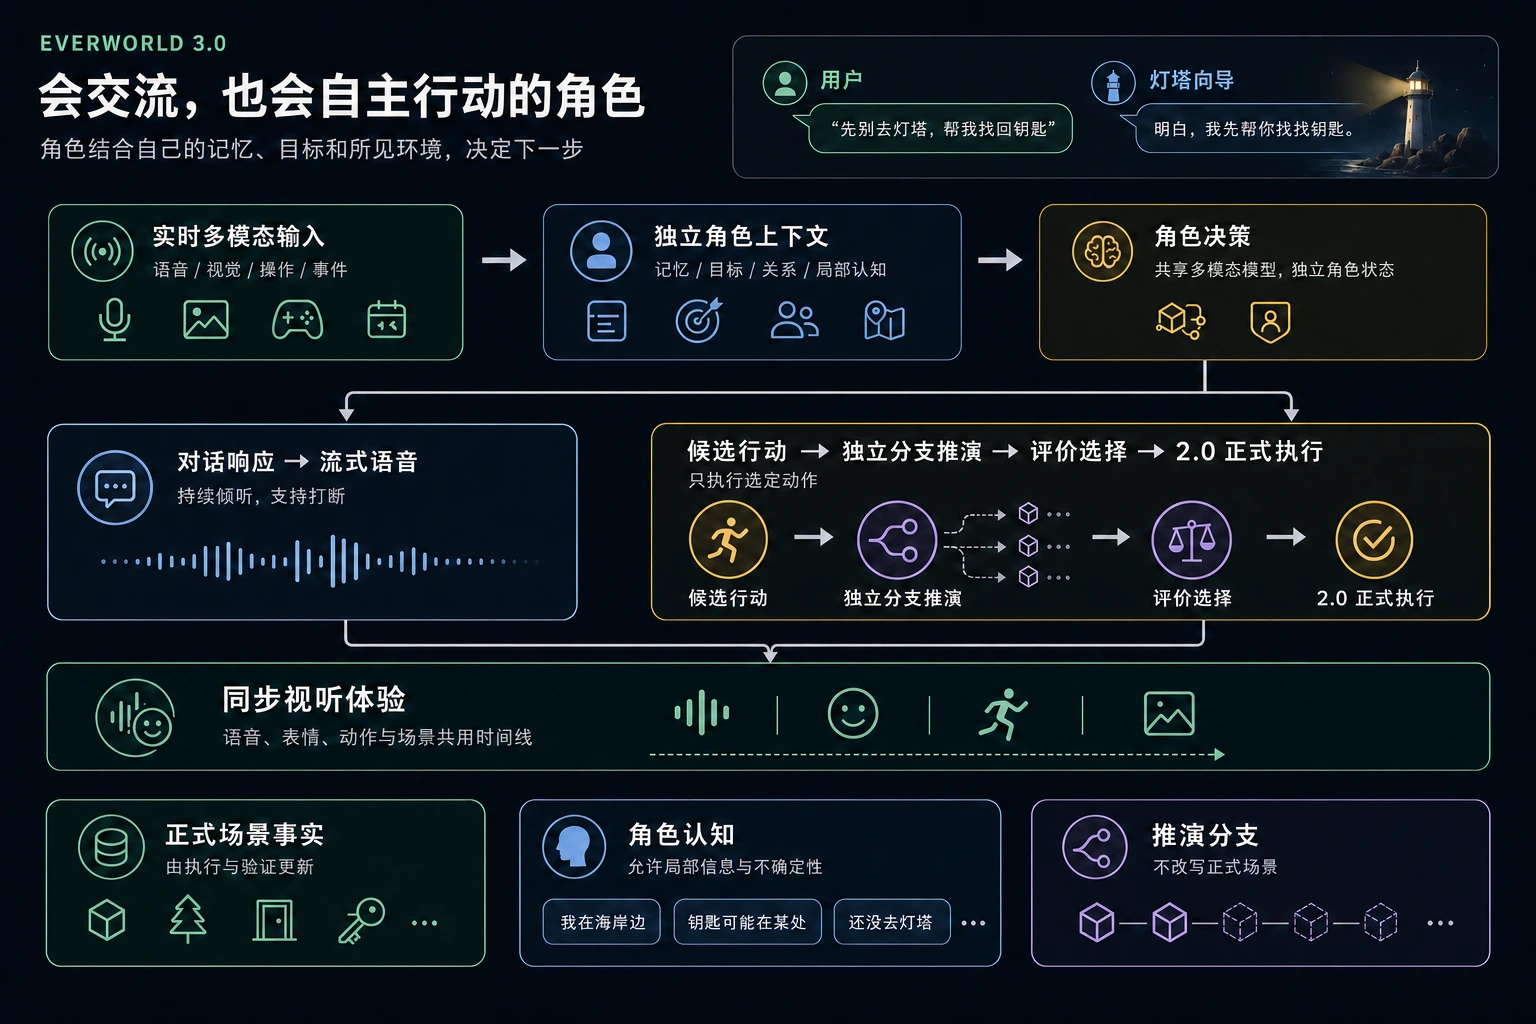
让智能体在 2.0 的可执行空间中交流、推演和自主行动。玩家可以插话与改口,角色依据独立记忆和目标持续推动场景演化。
能力如何实现
- 01在线全双工多模态互动
- 增加流式音频理解、增量多模态上下文、对话控制和流式语音解码;角色边听、边说、边行动,支持插话、改口和取消,并同步口型、动作与声音。
- 02具有记忆与目标的自主角色
- 采用共享多模态 MLLM+独立角色上下文,维护各自认知、经历、目标和关系;输出语言、技能选择和动作参数,高频动作交给控制器执行。
- 03行动前比较可能后果
- 从角色可知状态构建独立推演分支,复用 2.0 执行器,并结合不确定的行为预测评价候选动作;主要在状态与粗模层推演,降低计算成本。
- 04多智能体持续互动与场景演化
- 让行动改变任务、资源和关系,再由经历影响后续决策;通过共享时间、动作调度、冲突处理和分层更新,支持玩家离开后场景继续运行。
模型重点
新增具有记忆、目标和推演能力的流式多模态行动模型,复用 2.0 执行器与生成底座。正式场景事实、角色认知、假设推演分支分别维护;3D/4DGS 等复用技术作为降低长期运行成本的可选支撑。
在线感知 · 全双工 · 持续演化
让交流推动下一步行动
三个协同循环共享时间线、身份、意图版本和事件;较慢规划不会阻塞持续倾听。
在线交互循环
持续感知、增量理解、语音反馈与打断处理。
智能体决策循环
记忆与目标、分支推演、规划与修订。
场景执行循环
技能、物理状态、共同事件与空间视听反馈。
- 玩家
把剑拿过来。
- 智能体 · 说话中仍在倾听
我现在去拿……
- 玩家 · 插话
等等,换盾牌。
- 智能体 · 调整任务
改取盾牌,其他智能体继续行动。
停止说话、取消任务和停止动作分别处理;已经发生的后果继续保留。
深入理解
共享底座如何工作
从连贯交互、持久记忆到连续生成,按你关心的问题展开图解。
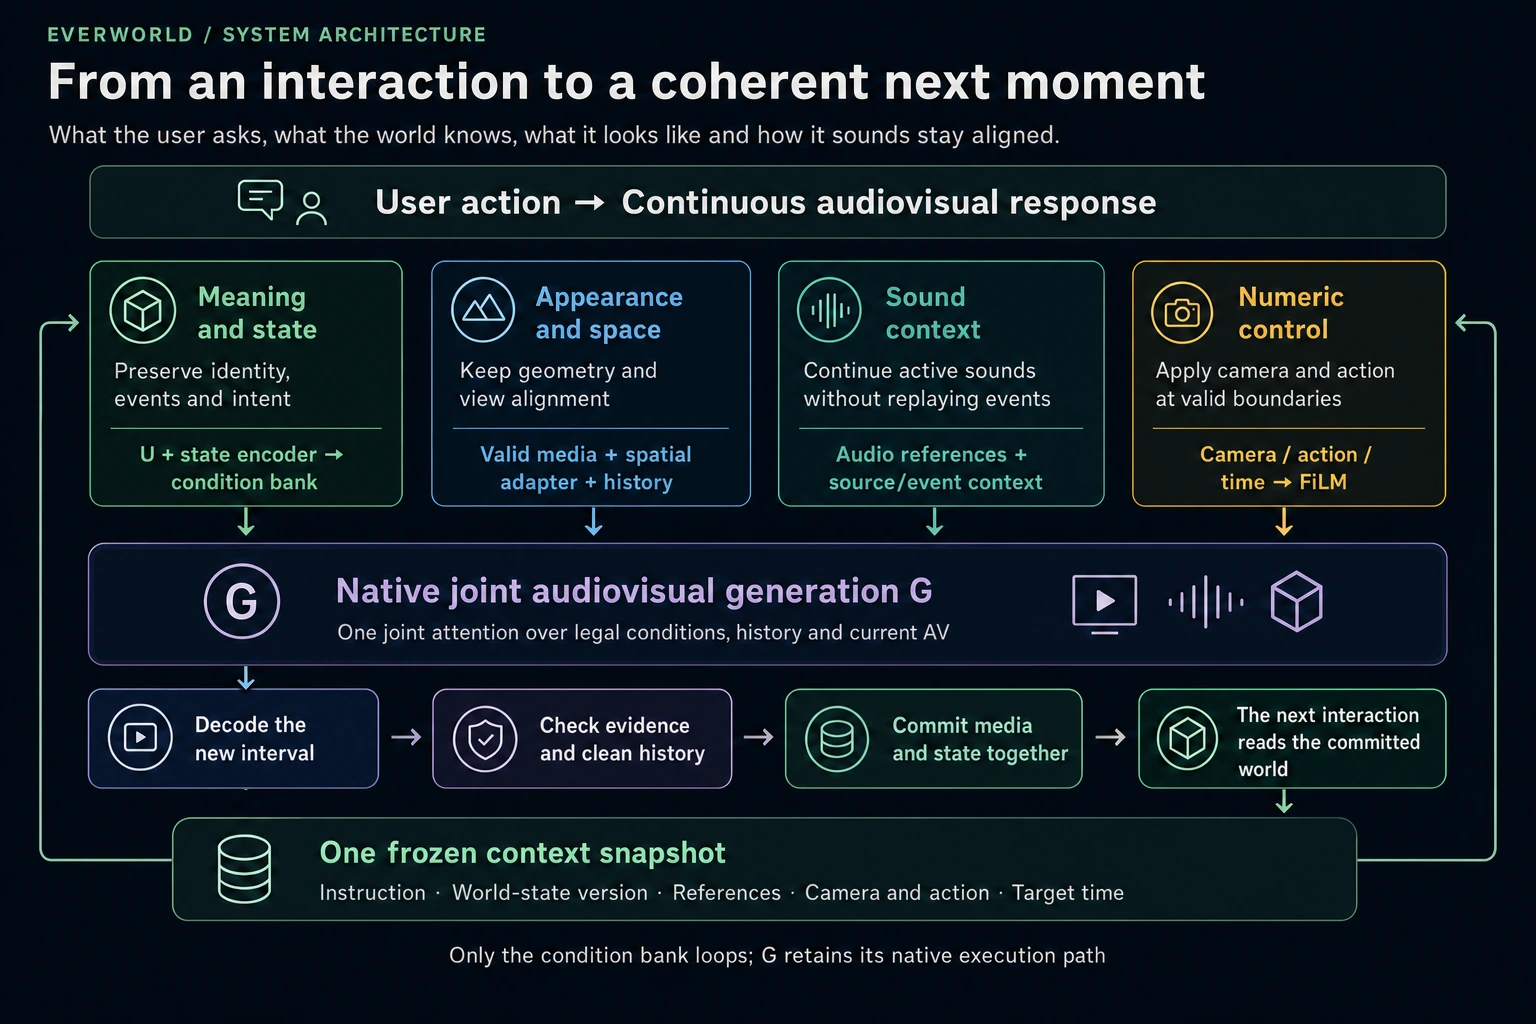
01从一次输入,到连贯的下一刻
语义、空间、声音和控制共同约束音视频生成;输出经过验证后,与状态一起提交,供下一轮交互使用。
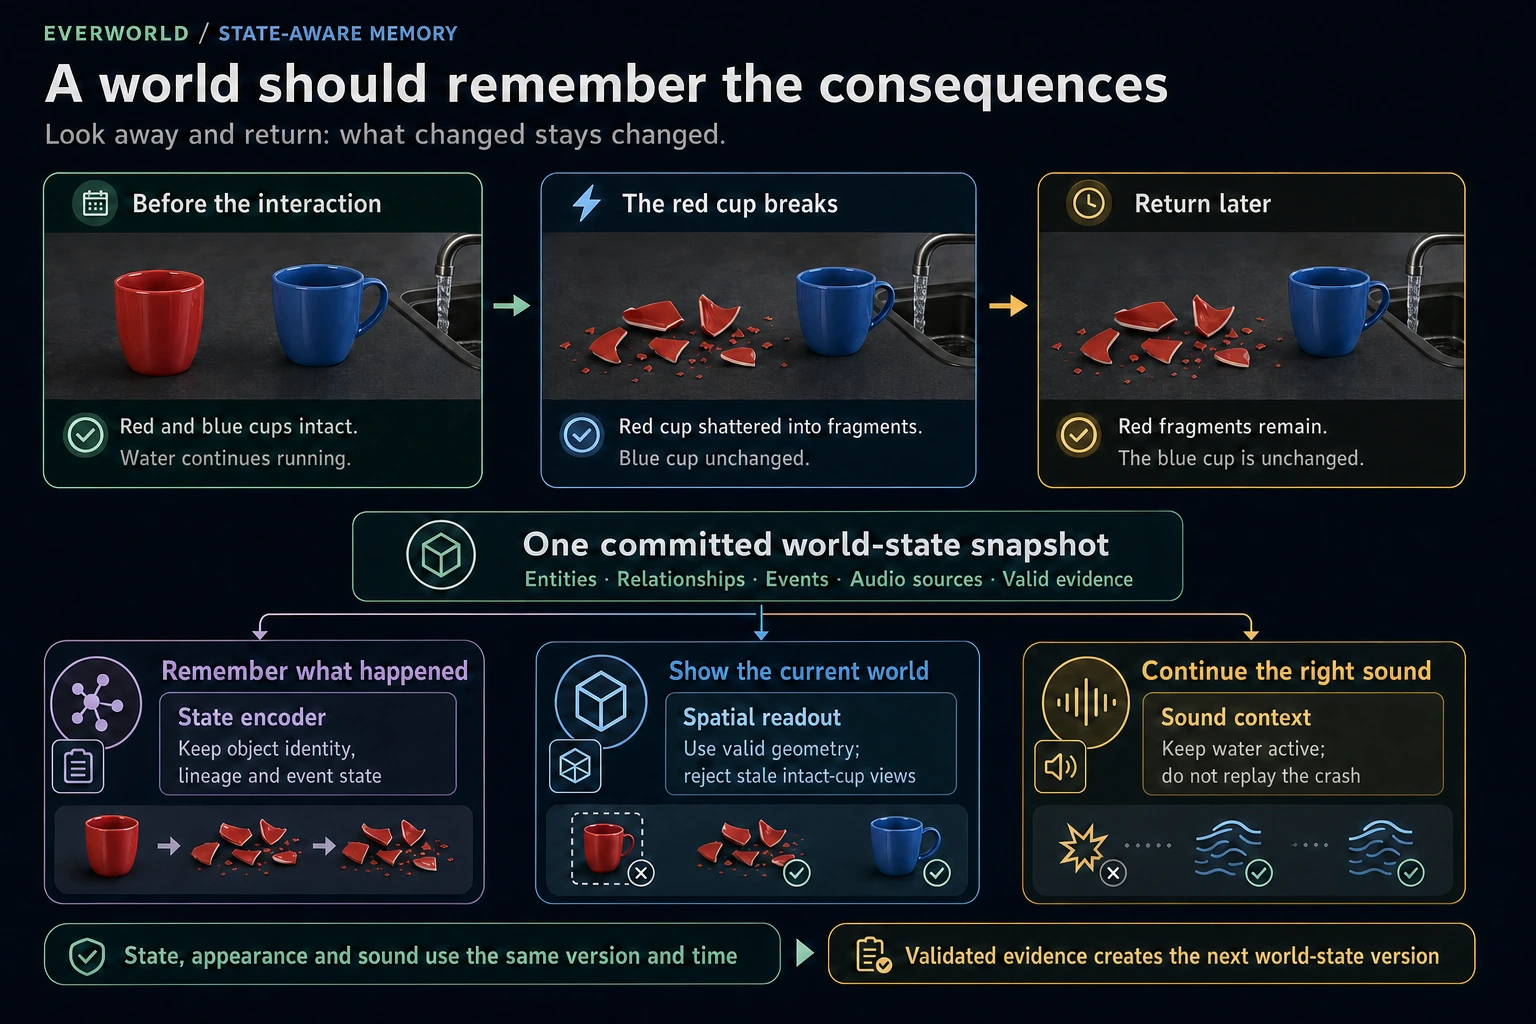
02让世界记住已经发生的变化
状态、外观和声音读取同一版本的世界。离开再回来,互动后果仍然存在,已经发生的一次性声音不会重新播放。
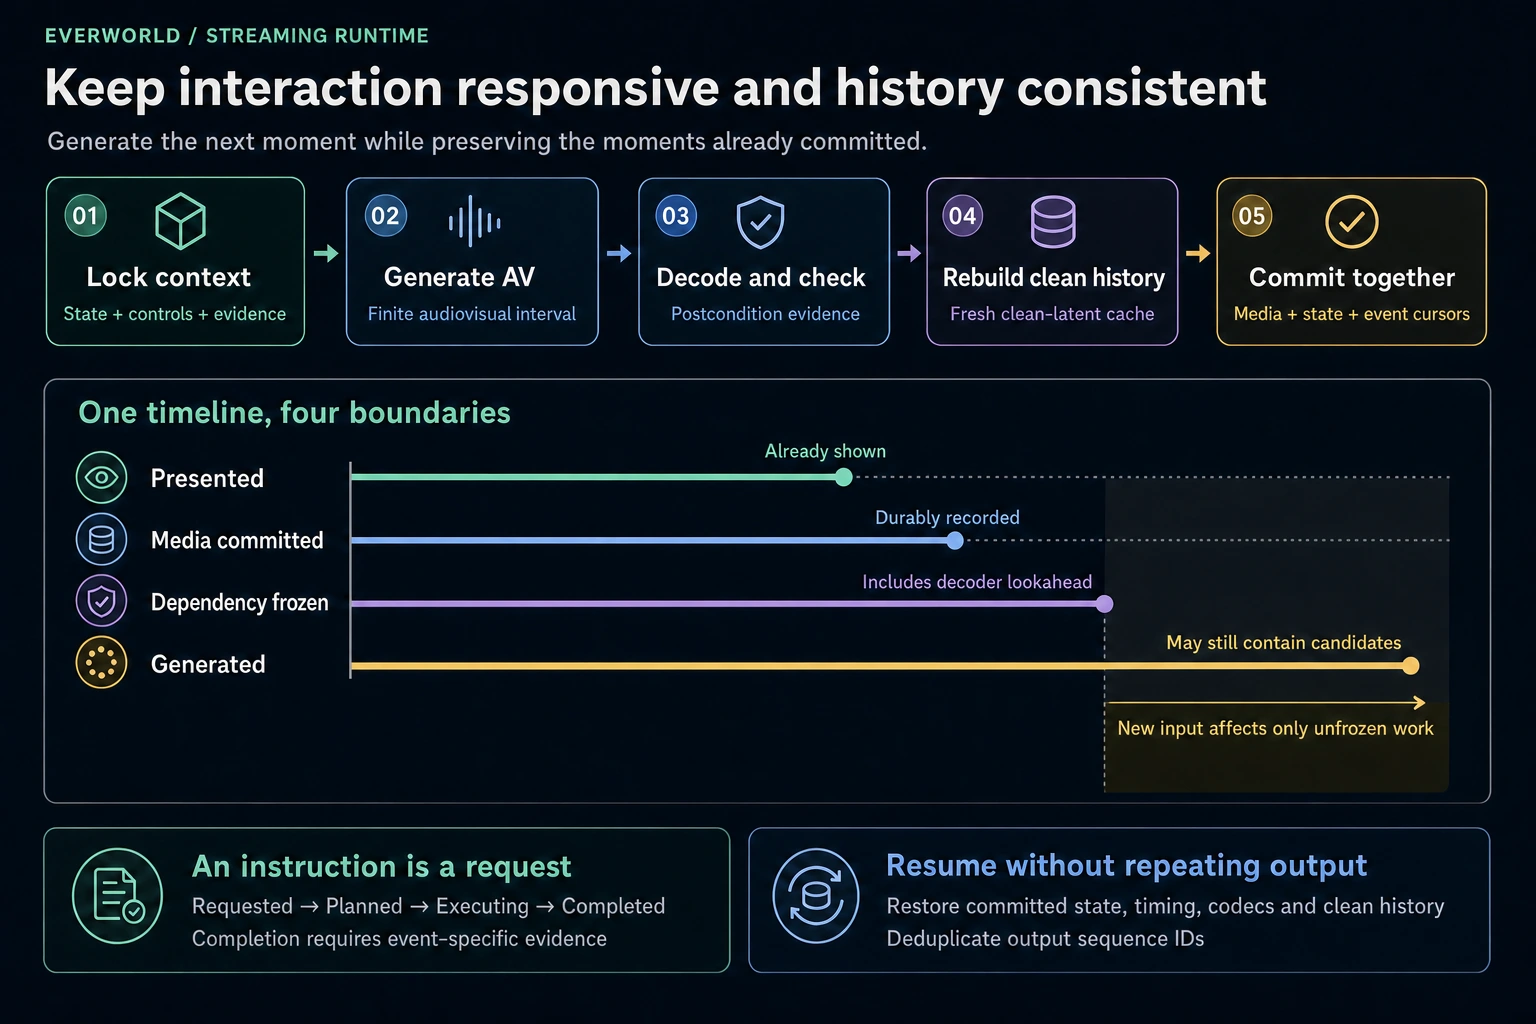
03交互持续进行,历史保持一致
按时间片生成、验证和提交。新指令影响仍可调整的内容,已经提交的历史保持一致。
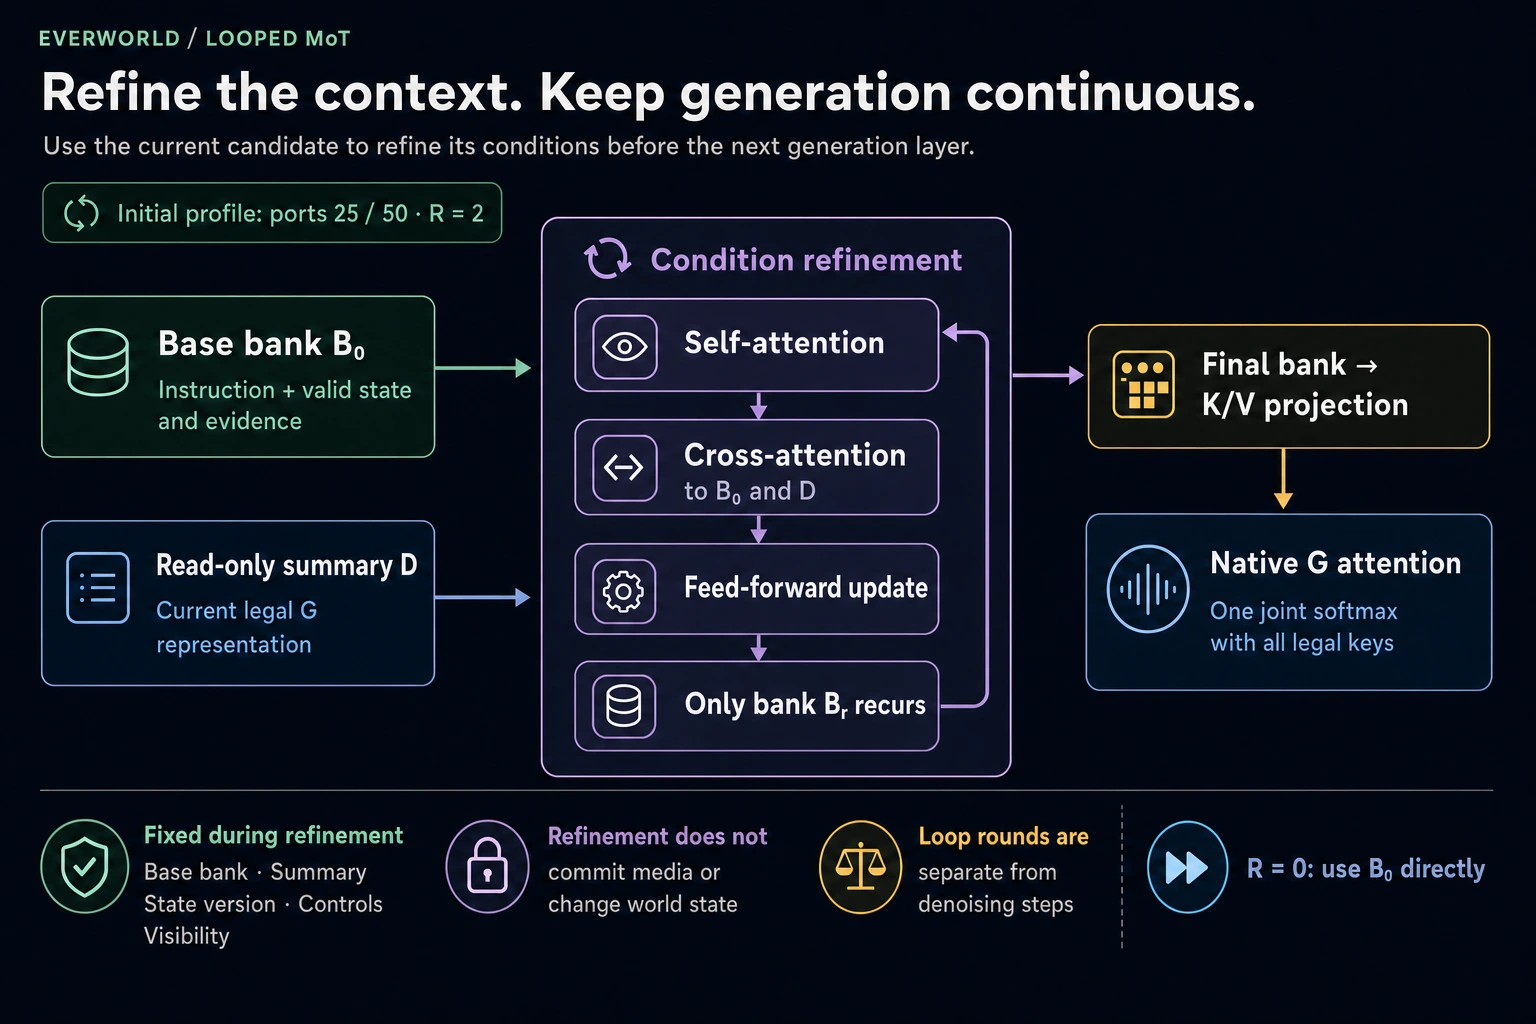
04先细化条件,再继续生成
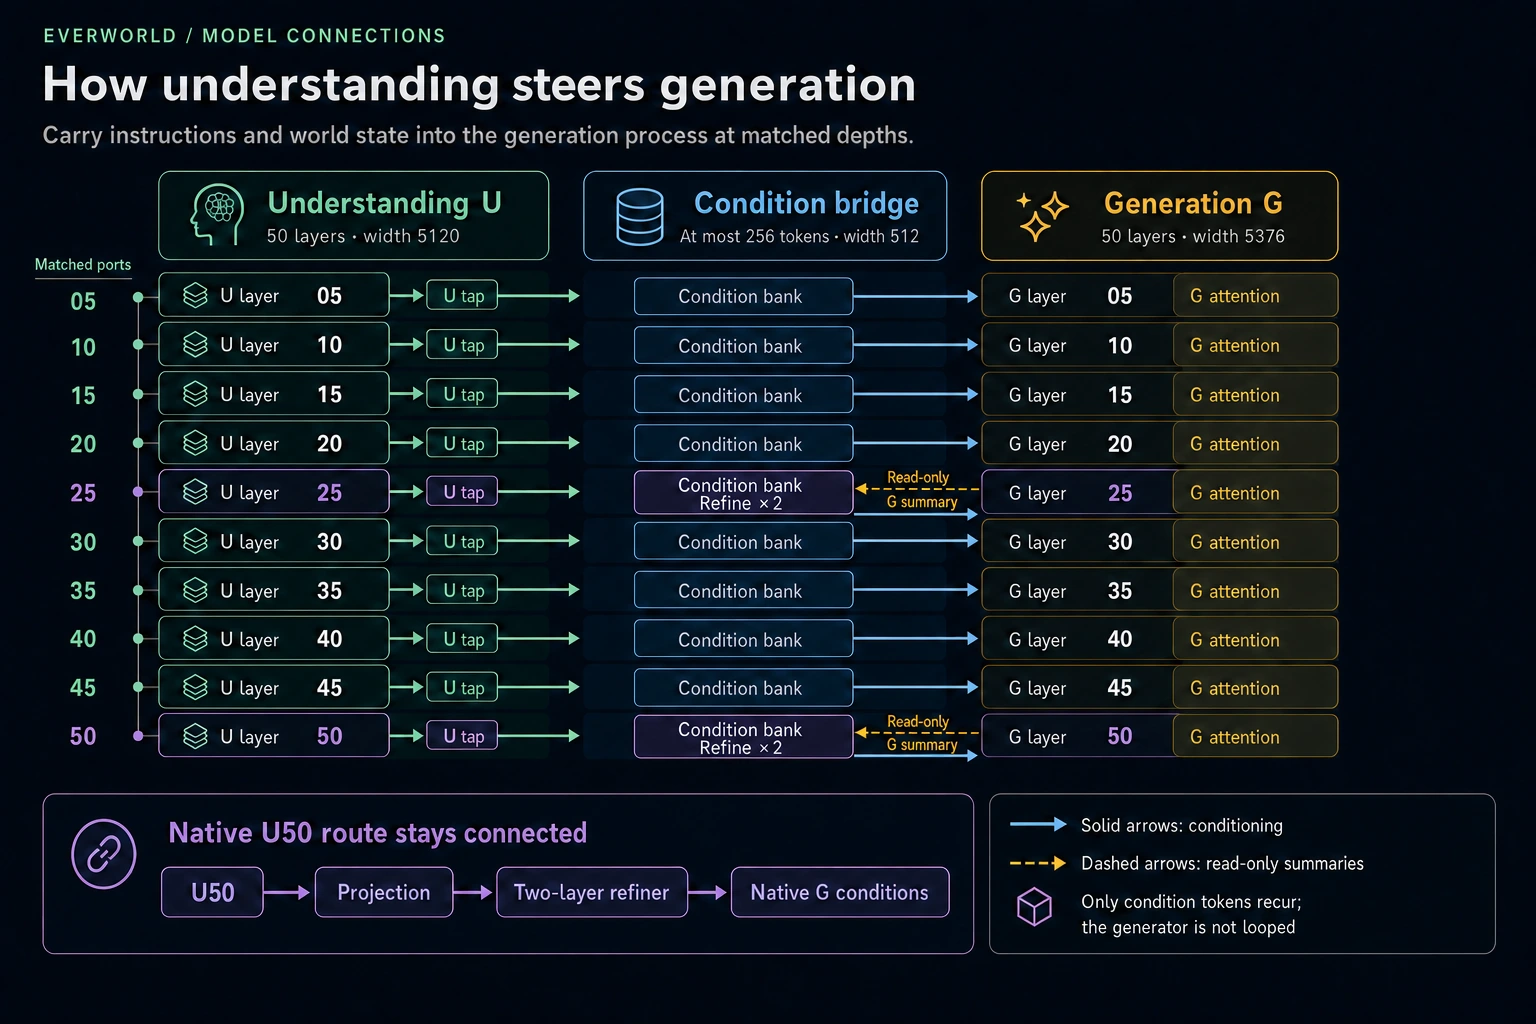
Looped MoT 根据固定输入和只读的生成摘要细化条件 token;生成器本身和正式世界状态不进入循环。
05把理解接入生成的每个关键位置
十个对应位置将理解与状态接入生成;25、50 两处细化条件,同时保留原生 U50 条件路径。
继续阅读